2026
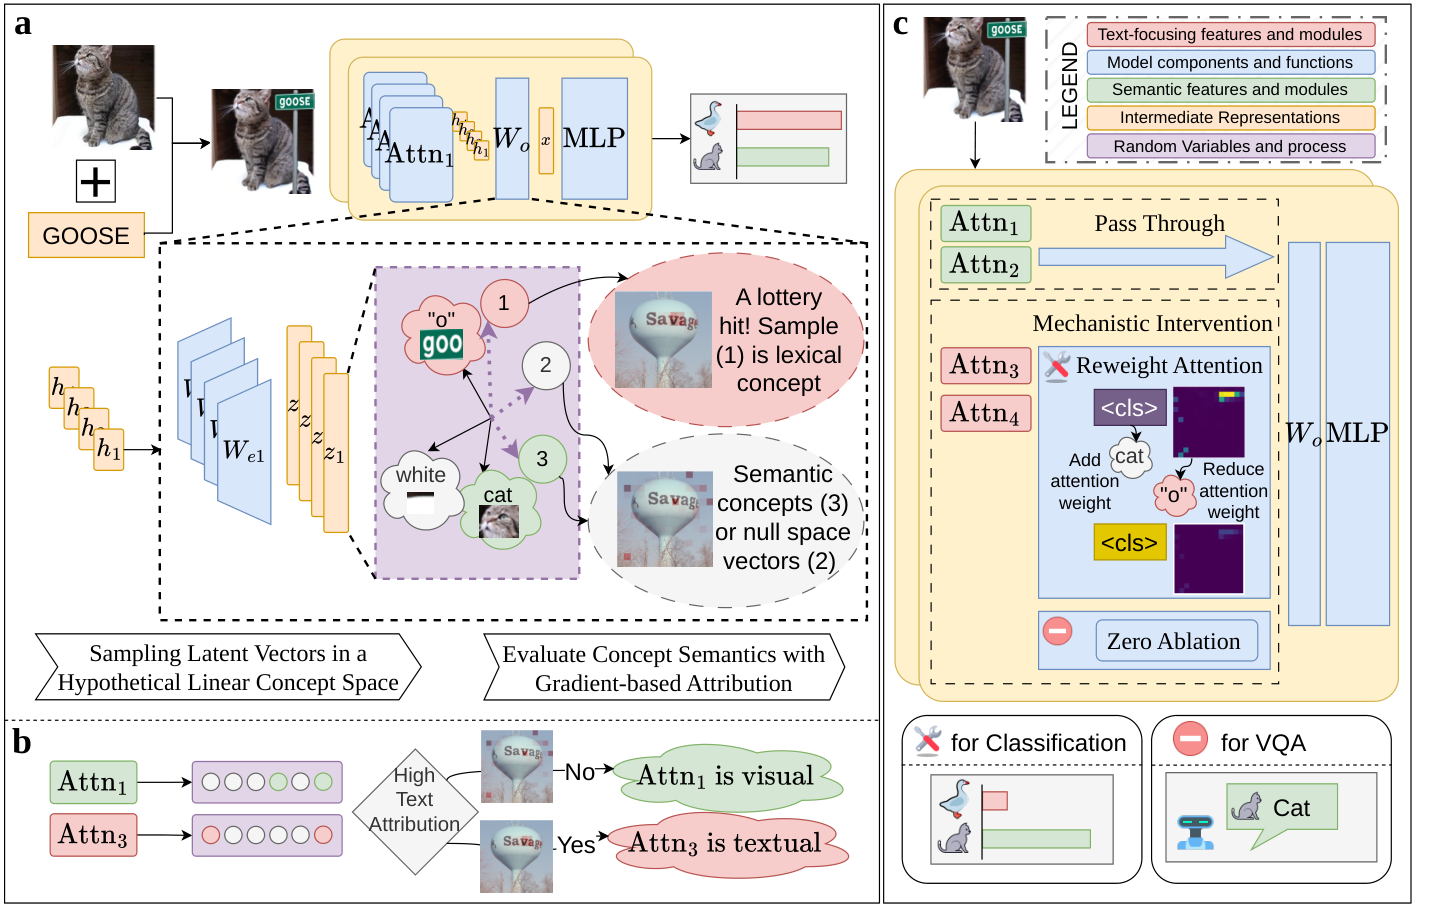
Towards Robustness against Typographic Attack with Training-free Concept Localization
Bohan Liu, Wenqian Ye, Guangzhi Xiong, Zhenghao He, Sanchit Sinha, Aidong Zhang
画在图片上的文字不应决定模型看到什么。我们无需训练即可定位出读取注入文字的少量CLIP注意力头,并对其重新加权或消融。在RTA-100(ViT-H/14)上目标准确率提升22.8分,推理成本几乎为零,在五种骨干网络上超越有监督与免训练防御。
MM-SPUBench: Towards Better Understanding of Spurious Biases in Multimodal LLMs
Wenqian Ye, B Liu, G Zheng, D Wang, X Cao, Y Ma, B Lai, JM Rehg, A Zhang
针对多模态大语言模型虚假偏差的基准测试:成对图像集使正确答案与虚假线索(背景、文字叠加、共现)无关。结果显示强大的多模态大模型严重依赖捷径,推动了具备偏见意识的评估与缓解。
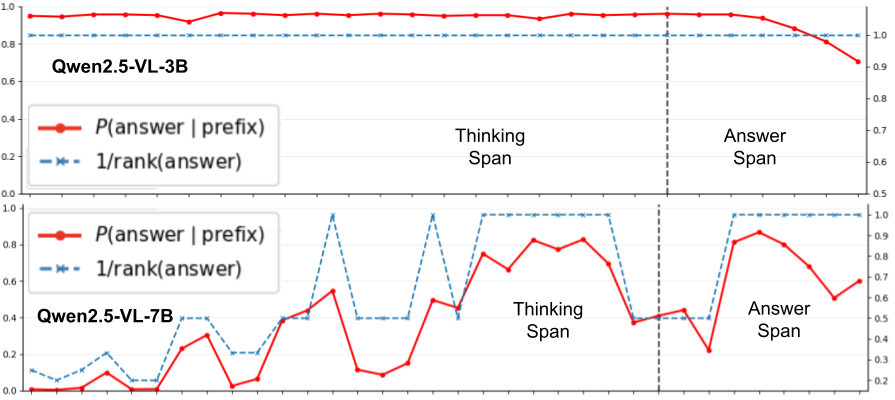
Attention-guided Fine-tuning of Multimodal Large Language Models Improves Chain-of-Thought Reasoning
S Sinha, G Xiong, B Liu, Z He, A Zhang
arXiv Jun 2026 论文 ↗
仅微调多模态大语言模型的少数注意力图(而非权重)即可改善思维链推理。注意力引导的更新在保留模型知识的同时控制其“关注哪里”,以远低于完全微调的成本提升ChartQA与CoT基准。
Toward Faithful Retrieval-Augmented Generation with Sparse Autoencoders
G Xiong, Z He, B Liu, S Sinha, A Zhang
RAG模型生成时常忽略检索到的证据。我们利用稀疏自编码器分解生成行为,找出影响忠实性的特征并加以引导——无需重新训练基础模型即可改善归因与依据。
SAGE: Spuriousness-Aware Guided Prompt Exploration for Mitigating Multimodal Bias
W Ye, D Wang, G Zheng, B Liu, A Zhang
提示词层面的多模态偏差防御:SAGE估计提示词的“虚假意识”程度,并探索引导式提示词变体,找出模型依赖真实视觉内容而非数据集捷径的表述方式。
Reasoning Beyond Chain-of-Thought: A Latent Computational Mode in Large Language Models
Z He, G Xiong, B Liu, S Sinha, A Zhang
思维链并非大语言模型唯一的推理方式。我们发现一种潜在计算模式——推理在生成任何token之前即于隐藏状态中完成——并刻画潜在计算优于显式CoT的条件。
2025
UrbanIR: Large-Scale Urban Scene Inverse Rendering from a Single Video
CH Lin, B Liu, YT Chen, KS Chen, D Forsyth, JB Huang, A Bhattad, et al.
从单段随手拍摄的视频进行大规模城市场景逆渲染:将城市分解为反照率、几何与瞬态光照,实现远超以往单张图像方法的逼真重光照与编辑。
2022
Online Classifier of AMICA Model to Evaluate State Anxiety While Standing in Virtual Reality
G Liao, S Wang, Z Wei, B Liu, R Okubo, ME Hernandez
基于AMICA脑电特征的在线分类器,可在人于虚拟现实中站立时检测状态焦虑——可应用于跌倒预防与VR治疗的实时监测。