2026
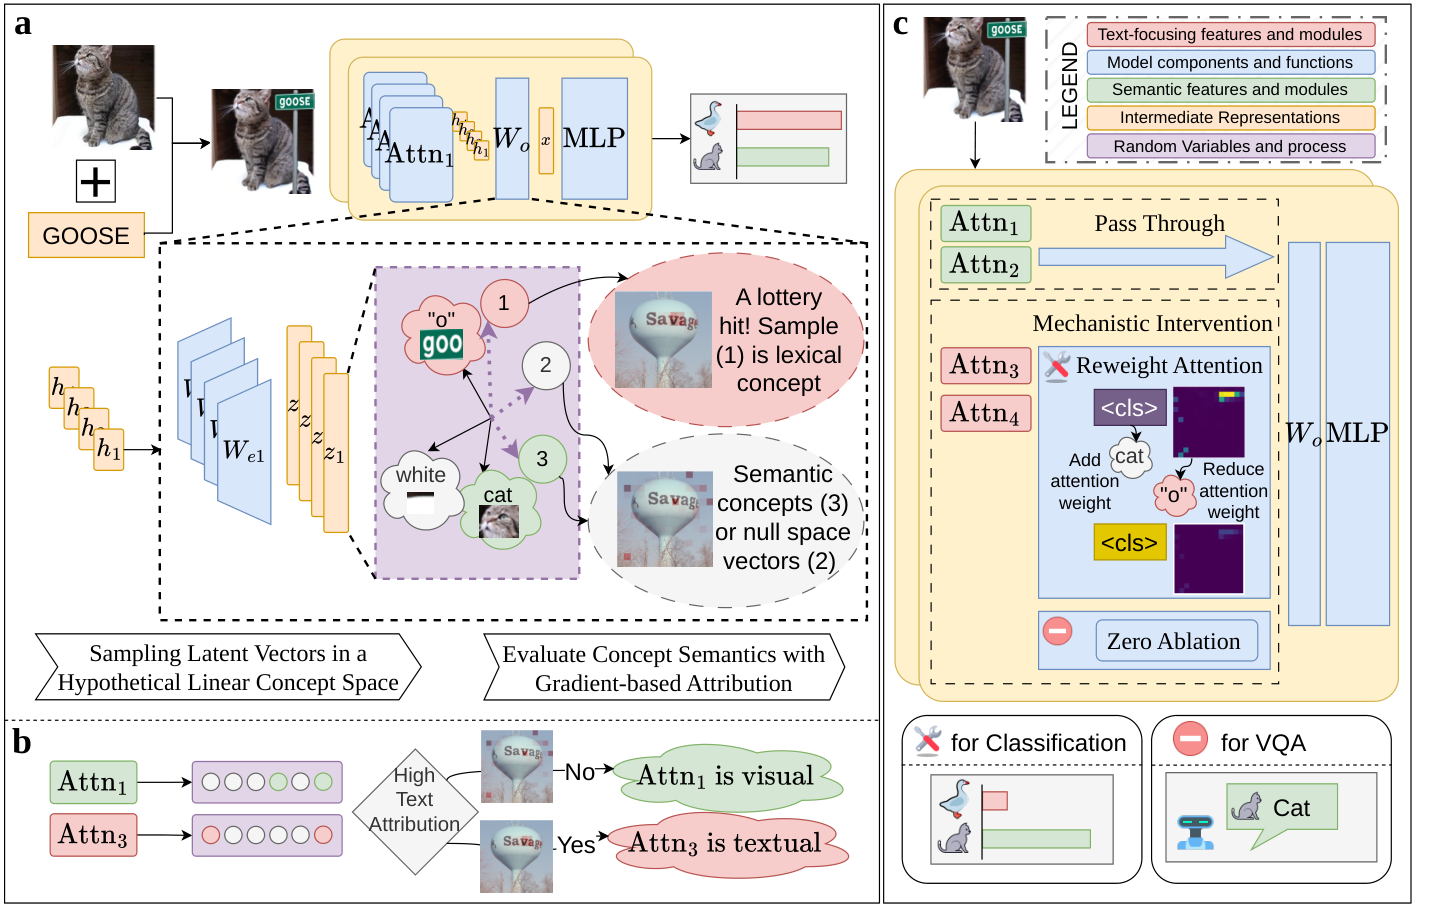
Towards Robustness against Typographic Attack with Training-free Concept Localization
Bohan Liu, Wenqian Ye, Guangzhi Xiong, Zhenghao He, Sanchit Sinha, Aidong Zhang
Le texte peint sur une image ne devrait pas décider de ce que le modèle voit. Nous localisons, sans apprentissage, le petit ensemble de têtes d'attention de CLIP qui lisent les mots injectés — puis les repondérons ou les ablations. +22,8 points de précision d'objets sur RTA-100 (ViT-H/14) pour un coût d'inférence quasi nul, surpassant les défenses supervisées et sans apprentissage sur cinq architectures.
MM-SPUBench: Towards Better Understanding of Spurious Biases in Multimodal LLMs
Wenqian Ye, B Liu, G Zheng, D Wang, X Cao, Y Ma, B Lai, JM Rehg, A Zhang
Un benchmark des biais fallacieux dans les LLM multimodaux : des paires d'images où la bonne réponse est indépendante des indices fallacieux (arrière-plans, textes superposés, cooccurrences). Révèle que les MLLM performants s'appuient fortement sur des raccourcis, motivant une évaluation et une atténuation conscientes des biais.
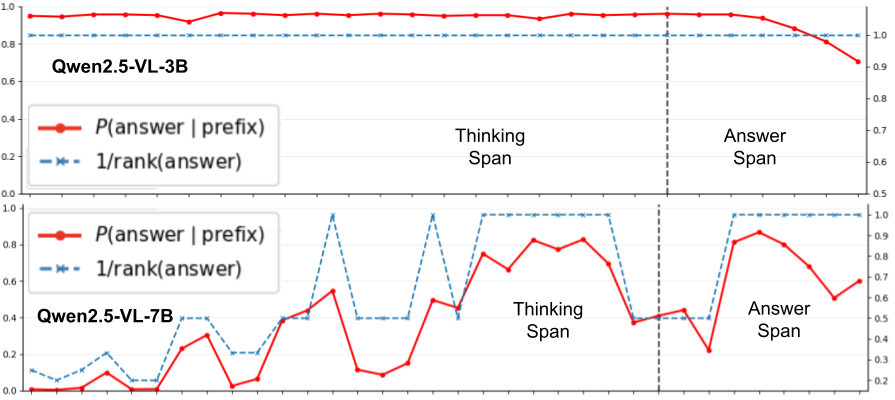
Attention-guided Fine-tuning of Multimodal Large Language Models Improves Chain-of-Thought Reasoning
S Sinha, G Xiong, B Liu, Z He, A Zhang
arXiv Jun 2026 article ↗
Affiner seulement quelques cartes d'attention — pas les poids — de LLM multimodaux améliore le raisonnement chaîne-de-pensée. Les mises à jour guidées par l'attention dirigent le regard du modèle tout en préservant ses connaissances, améliorant ChartQA et les benchmarks CoT pour une fraction du coût d'un affinage complet.
Toward Faithful Retrieval-Augmented Generation with Sparse Autoencoders
G Xiong, Z He, B Liu, S Sinha, A Zhang
Les modèles RAG ignorent souvent les preuves récupérées lors de la génération. Nous utilisons des autoencodeurs parcimonieux pour décomposer le comportement de génération, identifier les caractéristiques responsables de la fidélité et les orienter — améliorant l'attribution et l'ancrage sans réentraîner le modèle de base.
SAGE: Spuriousness-Aware Guided Prompt Exploration for Mitigating Multimodal Bias
W Ye, D Wang, G Zheng, B Liu, A Zhang
Défense au niveau du prompt contre le biais multimodal : SAGE estime à quel point un prompt est « conscient de la fallacité » et explore des variations guidées pour trouver des formulations où le modèle s'appuie sur le contenu visuel réel plutôt que sur des raccourcis de données.
Reasoning Beyond Chain-of-Thought: A Latent Computational Mode in Large Language Models
Z He, G Xiong, B Liu, S Sinha, A Zhang
La chaîne-de-pensée n'est pas la seule façon de raisonner des LLM. Nous mettons en évidence un mode de calcul latent — un raisonnement qui s'achève dans les états cachés avant toute émission de tokens — et caractérisons quand le calcul latent surpasse le CoT explicite.
2025
UrbanIR: Large-Scale Urban Scene Inverse Rendering from a Single Video
CH Lin, B Liu, YT Chen, KS Chen, D Forsyth, JB Huang, A Bhattad, et al.
Rendu inverse de scènes urbaines à grande échelle à partir d'une seule vidéo prise à la volée : décomposition de la ville en albédo, géométrie et éclairage transitoire, permettant un rééclairage et une édition photoréalistes bien au-delà des méthodes antérieures à image unique.
2022
Online Classifier of AMICA Model to Evaluate State Anxiety While Standing in Virtual Reality
G Liao, S Wang, Z Wei, B Liu, R Okubo, ME Hernandez
Un classifieur en ligne fondé sur des caractéristiques AMICA de l'EEG qui détecte l'anxiété état lorsqu'une personne debout évolue en réalité virtuelle — suivi en temps réel avec des applications à la prévention des chutes et à la thérapie par RV.