2026
Towards Robustness against Typographic Attack with Training-free Concept Localization
Bohan Liu, Wenqian Ye, Guangzhi Xiong, Zhenghao He, Sanchit Sinha, Aidong Zhang
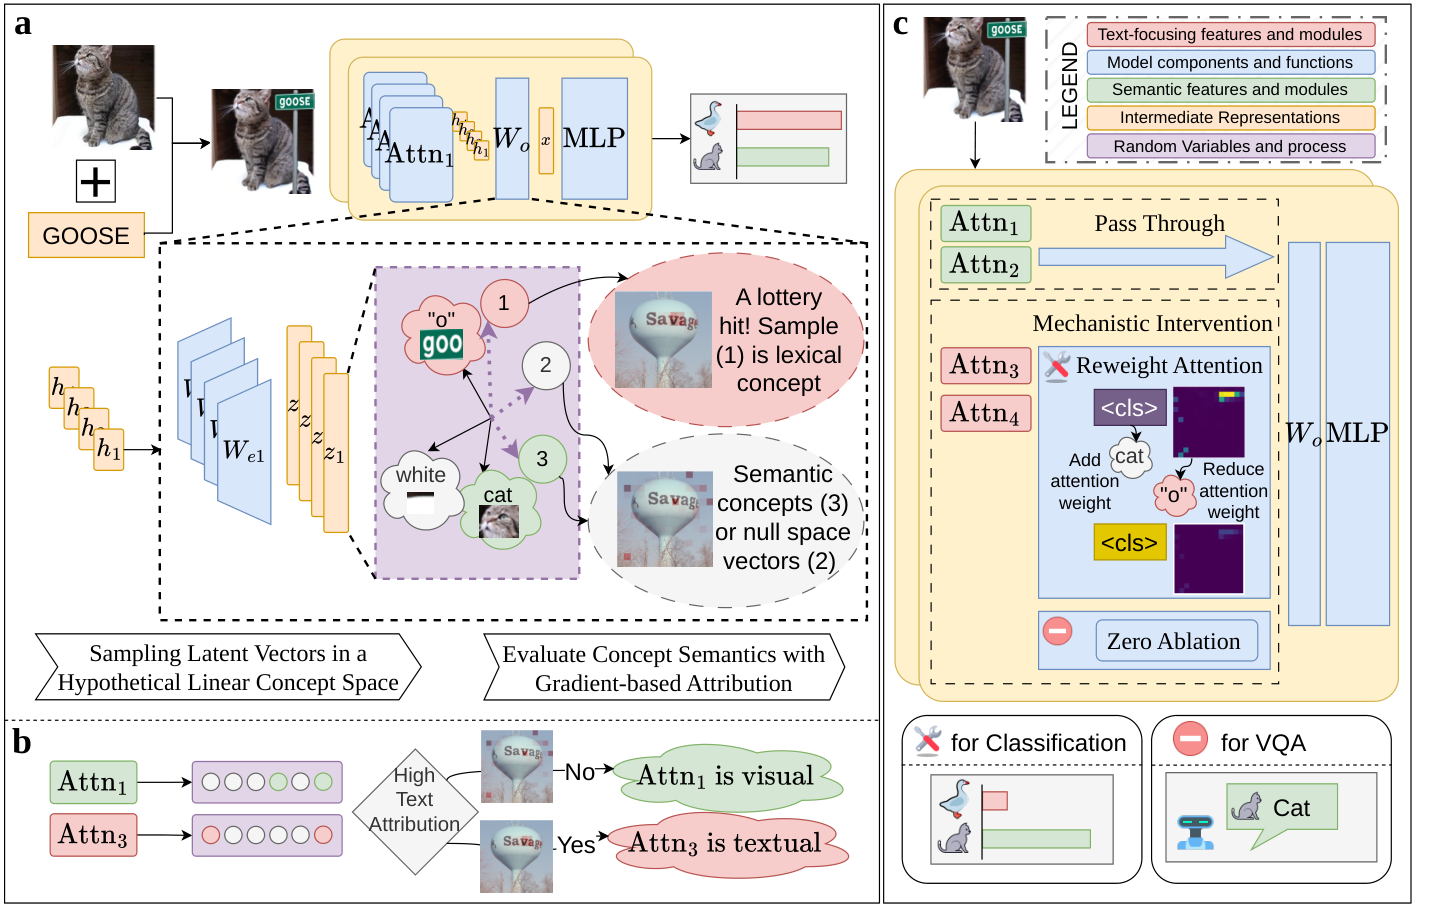
画像に描かれたテキストが、モデルの見ているものを決めてはいけません。注入された単語を読み取るCLIPの注意ヘッドの小さな集合を訓練なしで特定し、再重み付けまたは除去します。RTA-100(ViT-H/14)で物体認識精度+22.8ポイントを推論コストほぼゼロで達成し、5つのバックボーンで教師あり・訓練なし防御を上回ります。
MM-SPUBench: Towards Better Understanding of Spurious Biases in Multimodal LLMs
Wenqian Ye, B Liu, G Zheng, D Wang, X Cao, Y Ma, B Lai, JM Rehg, A Zhang
マルチモーダルLLMのスプリアスバイアスのベンチマーク:正解が見かけの手がかり(背景・テキスト重畳・共起)と無関係になるよう設計したペア画像セット。強力なMLLMがショートカットに大きく依存していることを明らかにし、バイアスを考慮した評価と緩和の必要性を示します。
Attention-guided Fine-tuning of Multimodal Large Language Models Improves Chain-of-Thought Reasoning
S Sinha, G Xiong, B Liu, Z He, A Zhang
arXiv Jun 2026 論文 ↗
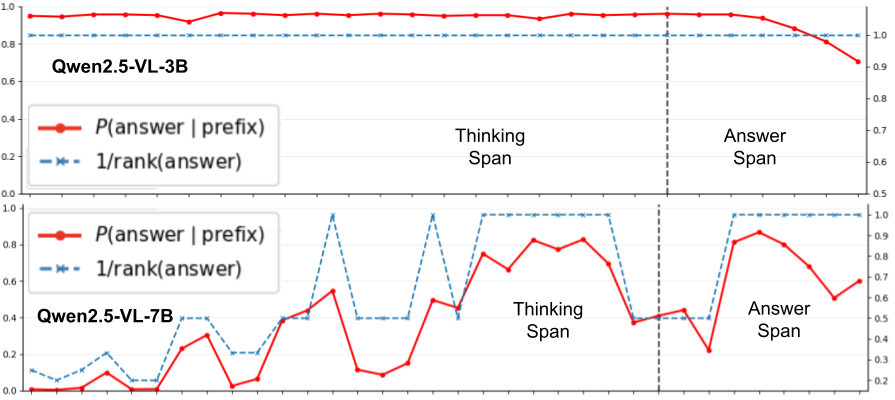
マルチモーダルLLMの重みではなく一部の注意マップのみをファインチューニングすることで、推論連鎖(CoT)が改善します。注意ガイド付き更新はモデルの知識を保ちつつ「どこを見るか」を制御し、フルファインチューニングのわずかなコストでChartQAやCoTベンチマークを向上させます。
Toward Faithful Retrieval-Augmented Generation with Sparse Autoencoders
G Xiong, Z He, B Liu, S Sinha, A Zhang
RAGモデルは生成時に検索された証拠を無視しがちです。スパースオートエンコーダで生成挙動を分解し、忠実性を担う特徴を特定・操作することで、ベースモデルの再訓練なしに帰属と根拠付けを改善します。
SAGE: Spuriousness-Aware Guided Prompt Exploration for Mitigating Multimodal Bias
W Ye, D Wang, G Zheng, B Liu, A Zhang
プロンプトレベルのマルチモーダルバイアス防御:SAGEはプロンプトの「スプリアス意識」の程度を推定し、モデルがデータセットのショートカットではなく真の視覚内容に依存するような誘導付きプロンプト変形を探索します。
Reasoning Beyond Chain-of-Thought: A Latent Computational Mode in Large Language Models
Z He, G Xiong, B Liu, S Sinha, A Zhang
推論連鎖はLLMの唯一の推論方法ではありません。トークンを生成する前に隠れ状態の中で完結する潜在的計算モードを発見し、潜在計算が明示的CoTを上回る条件を特徴付けます。
2025
UrbanIR: Large-Scale Urban Scene Inverse Rendering from a Single Video
CH Lin, B Liu, YT Chen, KS Chen, D Forsyth, JB Huang, A Bhattad, et al.
一枚の日常的に撮影された動画からの大規模都市シーン逆レンダリング:都市をアルベド・幾何・一時的照明に分解し、従来の単一画像手法を大きく超える写実的な再照明・編集を可能にします。
2022
Online Classifier of AMICA Model to Evaluate State Anxiety While Standing in Virtual Reality
G Liao, S Wang, Z Wei, B Liu, R Okubo, ME Hernandez
AMICAのEEG特徴に基づくオンライン分類器が、VR空間で立っている際の状態不安を検出します — 転倒予防やVR治療への応用が期待されるリアルタイムモニタリング。