
プロフィール
私はバージニア大学コンピュータサイエンス学科の博士課程に在籍し、指導教員は Aidong Zhang教授です。 研究範囲はビジョン、言語、頑健性であり、特にマルチモーダル大規模言語モデルのスプリアスバイアスの理解と緩和、スパースオートエンコーダによるモデル内部の解釈性・忠実性の向上に取り組んでいます。UVA、UIUC、Georgia Tech、Waymo、Amazon AGIの研究者と密接に共同研究を行っています。
UVA以前は、 イリノイ大学アーバナ・シャンペーン校で学士号およびコンピュータサイエンス修士号を取得し、Bronze Tablet Awardを受賞しました (参照: 実際の記念プレート; 設置場所)。 学部時代は都市シーンの逆レンダリングをShenlong Wang教授のグループ(UrbanIR)で研究し、イリノイ宇宙グラントコンソーシアムでは複合現実による構造モニタリング研究にも従事しました。
メール: bohan@virginia.edu
研究関心
もう一度タグをクリックすると閉じます
⚡ このアニメーションを自分のサイトでも使えます。詳しくは Concept Canvas — 393のコンピューティング概念を、2行のコードで埋め込めます。
主要な研究業績
Towards Robustness against Typographic Attack with Training-free Concept Localization
Bohan Liu, Wenqian Ye, Guangzhi Xiong, Zhenghao He, Sanchit Sinha, Aidong Zhang
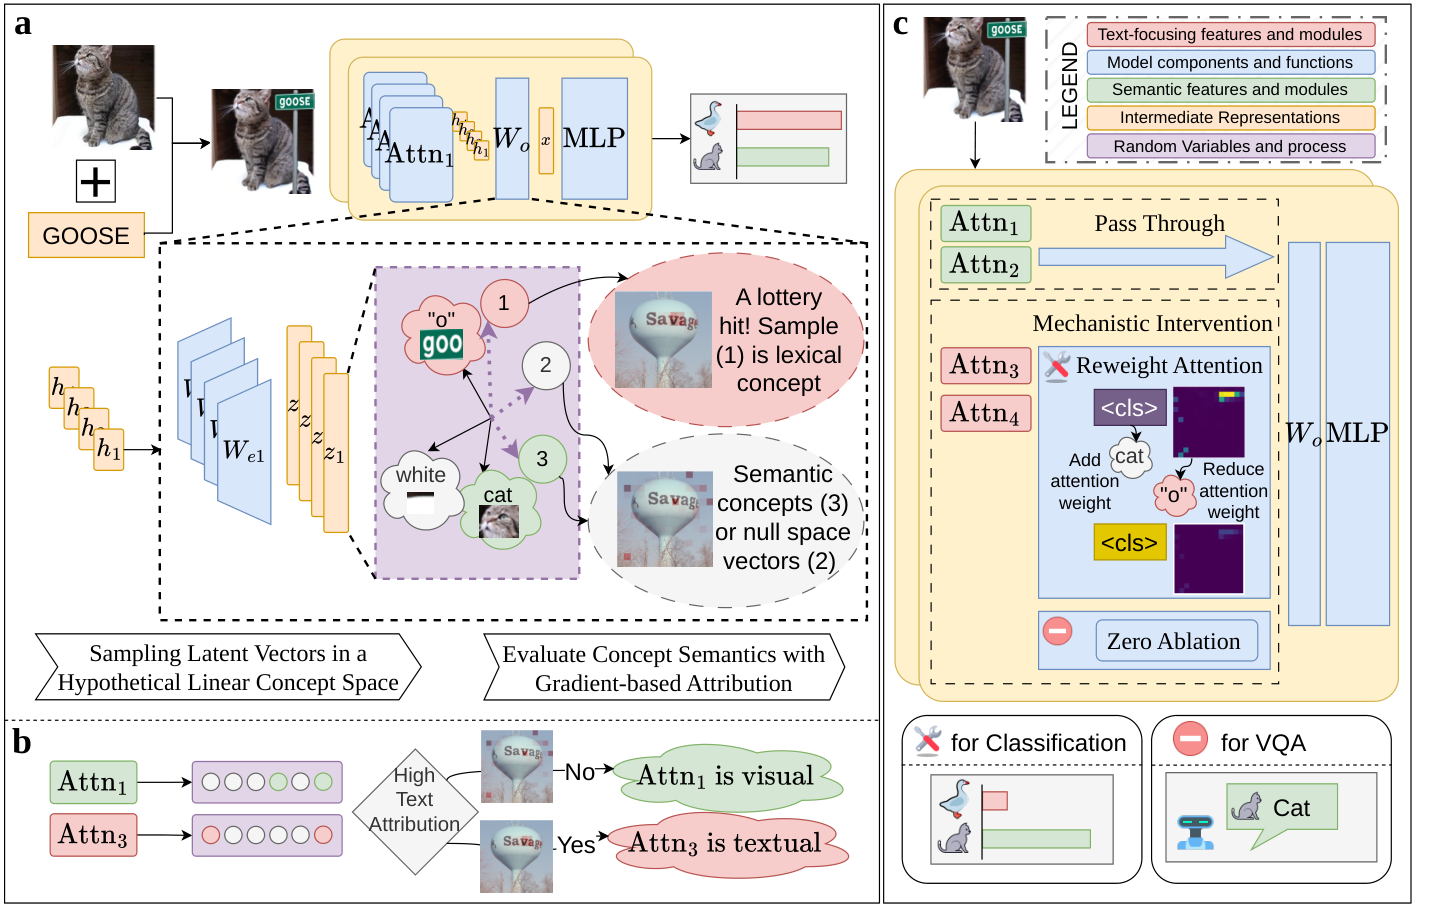
画像に描かれたテキストが、モデルの見ているものを決めてはいけません。注入された単語を読み取るCLIPの注意ヘッドの小さな集合を訓練なしで特定し、再重み付けまたは除去します。RTA-100(ViT-H/14)で物体認識精度+22.8ポイントを推論コストほぼゼロで達成し、5つのバックボーンで教師あり・訓練なし防御を上回ります。
MM-SPUBench: Towards Better Understanding of Spurious Biases in Multimodal LLMs
Wenqian Ye, B Liu, G Zheng, D Wang, X Cao, Y Ma, B Lai, JM Rehg, A Zhang
マルチモーダルLLMのスプリアスバイアスのベンチマーク:正解が見かけの手がかり(背景・テキスト重畳・共起)と無関係になるよう設計したペア画像セット。強力なMLLMがショートカットに大きく依存していることを明らかにし、バイアスを考慮した評価と緩和の必要性を示します。
Toward Faithful Retrieval-Augmented Generation with Sparse Autoencoders
G Xiong, Z He, B Liu, S Sinha, A Zhang
RAGモデルは生成時に検索された証拠を無視しがちです。スパースオートエンコーダで生成挙動を分解し、忠実性を担う特徴を特定・操作することで、ベースモデルの再訓練なしに帰属と根拠付けを改善します。
UrbanIR: Large-Scale Urban Scene Inverse Rendering from a Single Video
CH Lin, B Liu, YT Chen, KS Chen, D Forsyth, JB Huang, A Bhattad, et al.
一枚の日常的に撮影された動画からの大規模都市シーン逆レンダリング:都市をアルベド・幾何・一時的照明に分解し、従来の単一画像手法を大きく超える写実的な再照明・編集を可能にします。
全リストは研究業績ページと Google Scholar.
学術活動
ワークショップ
査読
査読者 · NeurIPS · 2026
査読者 · AAAI · 2027
教育・メンタリング
ティーチングアシスタント · CS 415 ゲーム開発, CS 410 テキスト情報システム · UIUC 2023–24
コースアシスタント · CS 125 コンピュータサイエンス入門 · UIUC 2020
メンター · Worldwide Youth in Science and Engineering (WYSE) · UIUC 2022