
关于我
我是弗吉尼亚大学计算机科学系博士研究生,导师为Aidong Zhang教授。我的研究涵盖视觉、语言与鲁棒性——特别是理解并缓解多模态大语言模型中由虚假相关引发的偏差,以及利用稀疏自编码器使模型内部可解释且忠实。我与UVA、UIUC、Georgia Tech、Waymo及Amazon AGI的研究人员密切合作。
在UVA之前,我于 伊利诺伊大学厄巴纳-香槟分校取得学士与计算机科学硕士学位,并获颁Bronze Tablet奖 (见实体奖牌; 奖牌位置)。 本科期间,我随Shenlong Wang教授的团队(UrbanIR)研究城市场景逆渲染,并与Illinois Space Grant Consortium合作研究混合现实结构监测。
研究兴趣
再次点击标签即可关闭
⚡ 想在自己的网站上使用这些动画?请见 Concept Canvas —— 393个计算概念,两行代码即可嵌入。
精选论文
Towards Robustness against Typographic Attack with Training-free Concept Localization
Bohan Liu, Wenqian Ye, Guangzhi Xiong, Zhenghao He, Sanchit Sinha, Aidong Zhang
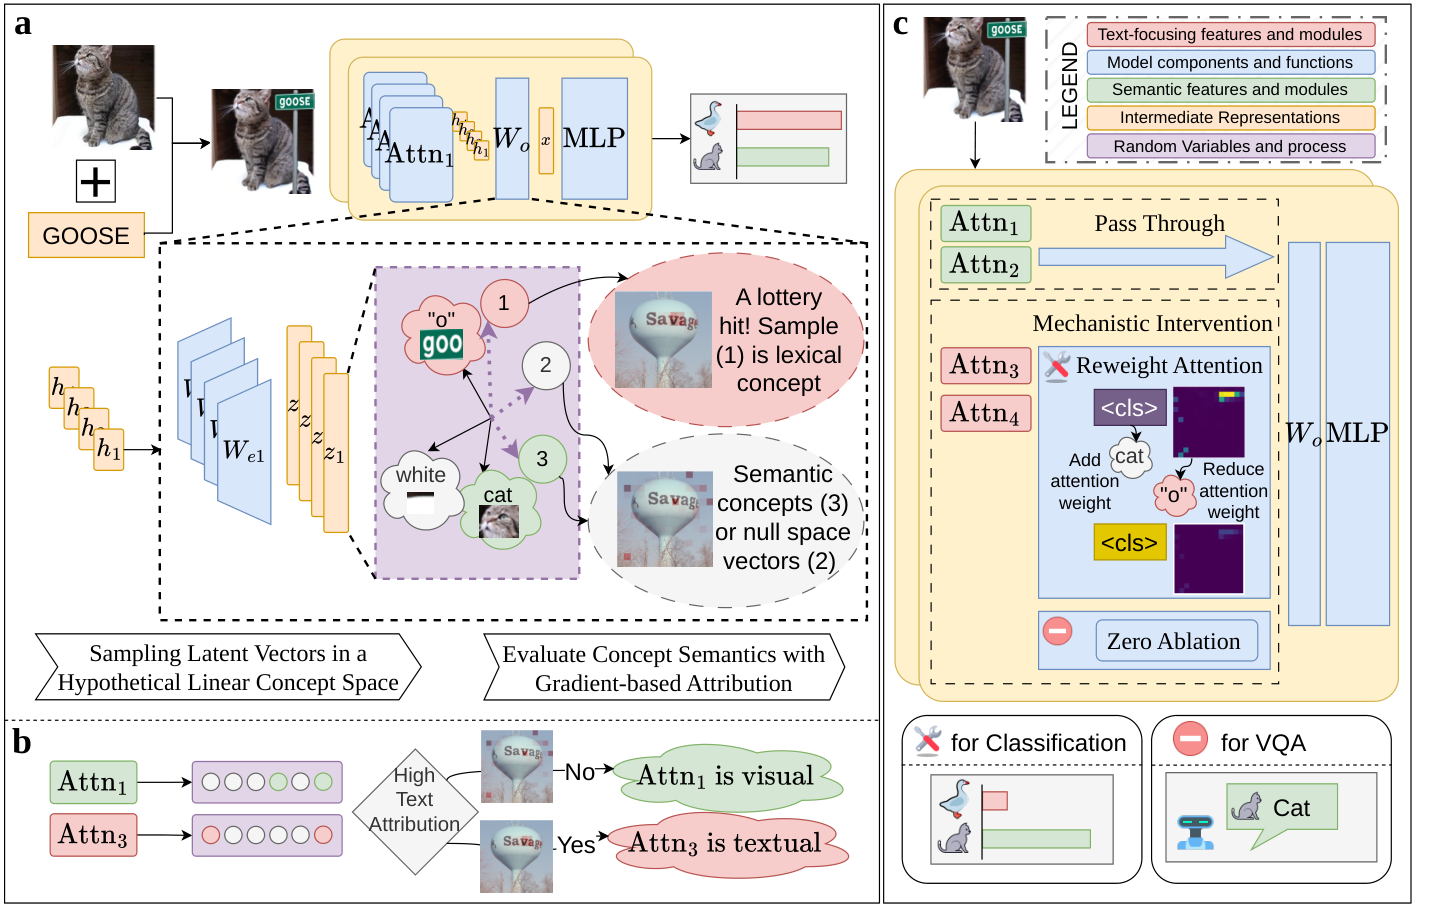
画在图片上的文字不应决定模型看到什么。我们无需训练即可定位出读取注入文字的少量CLIP注意力头,并对其重新加权或消融。在RTA-100(ViT-H/14)上目标准确率提升22.8分,推理成本几乎为零,在五种骨干网络上超越有监督与免训练防御。
MM-SPUBench: Towards Better Understanding of Spurious Biases in Multimodal LLMs
Wenqian Ye, B Liu, G Zheng, D Wang, X Cao, Y Ma, B Lai, JM Rehg, A Zhang
针对多模态大语言模型虚假偏差的基准测试:成对图像集使正确答案与虚假线索(背景、文字叠加、共现)无关。结果显示强大的多模态大模型严重依赖捷径,推动了具备偏见意识的评估与缓解。
Toward Faithful Retrieval-Augmented Generation with Sparse Autoencoders
G Xiong, Z He, B Liu, S Sinha, A Zhang
RAG模型生成时常忽略检索到的证据。我们利用稀疏自编码器分解生成行为,找出影响忠实性的特征并加以引导——无需重新训练基础模型即可改善归因与依据。
UrbanIR: Large-Scale Urban Scene Inverse Rendering from a Single Video
CH Lin, B Liu, YT Chen, KS Chen, D Forsyth, JB Huang, A Bhattad, et al.
从单段随手拍摄的视频进行大规模城市场景逆渲染:将城市分解为反照率、几何与瞬态光照,实现远超以往单张图像方法的逼真重光照与编辑。
完整列表见论文页面与 Google Scholar.
学术服务
工作坊
同行评审
审稿人 · NeurIPS · 2026
审稿人 · AAAI · 2027
教学与指导
助教 · CS 415 游戏开发, CS 410 文本信息系统 · UIUC 2023–24
课程助理 · CS 125 计算机科学导论 · UIUC 2020
导师 · Worldwide Youth in Science and Engineering (WYSE) · UIUC 2022